Comprendre le fonctionnement d’une application sans disposer de son code source reste l’un des exercices les plus chronophages du développement. C’est précisément la promesse de REA (Reverse Engineer Anything) : laisser votre agent d’IA interroger un binaire, une application JavaScript ou un APK, et recevoir des réponses étayées par des preuves vérifiables. Nous l’avons installé puis testé pendant plusieurs heures sur Ubuntu 24.04, avec de vraies cibles : notre site web, notre propre application Android et les binaires du système.
REA, qu’est-ce que c’est ?
Publié sous licence MIT depuis avril 2026, REA est à la fois un serveur Model Context Protocol (MCP) et une ligne de commande complète (155 commandes listées par rea --help). Le projet se positionne comme une couche unique d’analyse : binaires natifs (ELF, PE, Mach-O), applications JavaScript et Electron, assemblages .NET, APK Android, pages web, firmwares, WASM, captures réseau… Le dépôt affiche aujourd’hui plus de 412 000 étoiles, 103 000 forks et 6 263 commits, avec des releases npm quasi hebdomadaires (la dernière, rea-agents 6.8.0, est sortie le 25 octobre 2026).
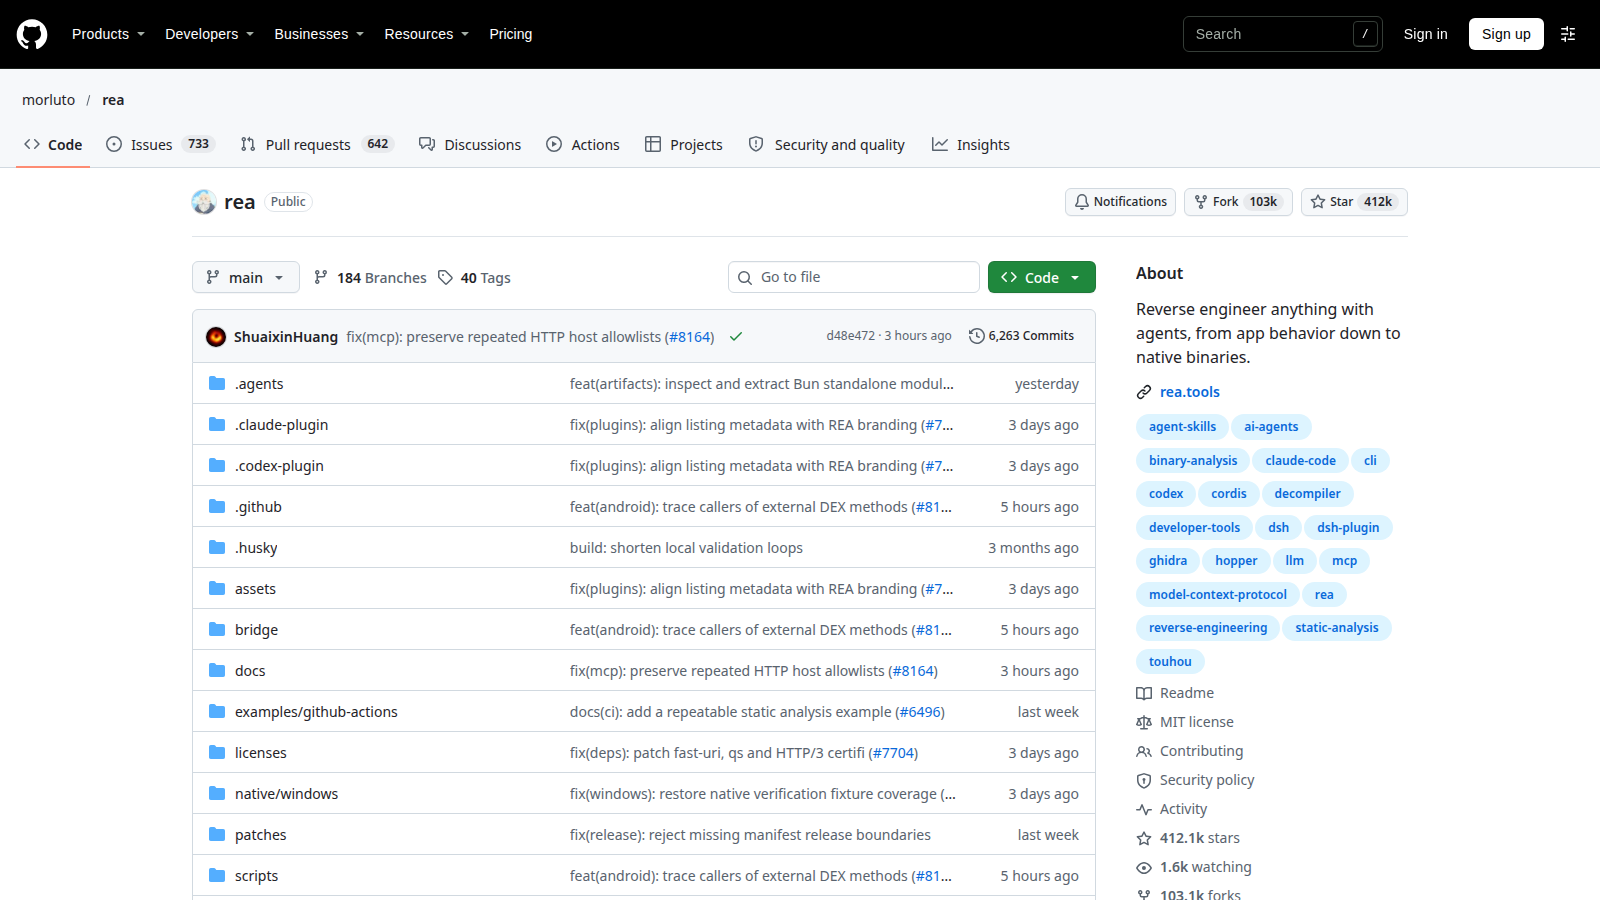
Le principe central s’appelle la Preuve (« Evidence ») : chaque opération renvoie un objet structuré contenant l’empreinte SHA-256 du fichier analysé, le code retour, les limitations et le niveau de confiance. L’agent (ou l’humain) sait donc toujours ce qui a été observé, ce qui a été inféré, et ce qui reste inconnu. C’est ce qui distingue REA d’un simple « gadget » d’IA qui affirme des choses sans les sourcer.
Installation et prise en main
L’installation est volontairement minimale — il faut Node.js 22 ou plus récent :
npm install -g rea-agentspour obtenir la commanderea(ounpx rea-agents setupdirectement) ;rea setup: on choisit les agents à enregistrer (Claude Code, Codex, Cursor, Gemini CLI, OpenCode, VS Code, Copilot CLI…), les modifications sont proposées avec sauvegarde ;- redémarrer l’agent, puis lancer
rea doctorpour auditer l’environnement ; - optionnel : brancher un moteur d’analyse native (Ghidra, Hopper, IDA…) si vous visez les binaires compilés.
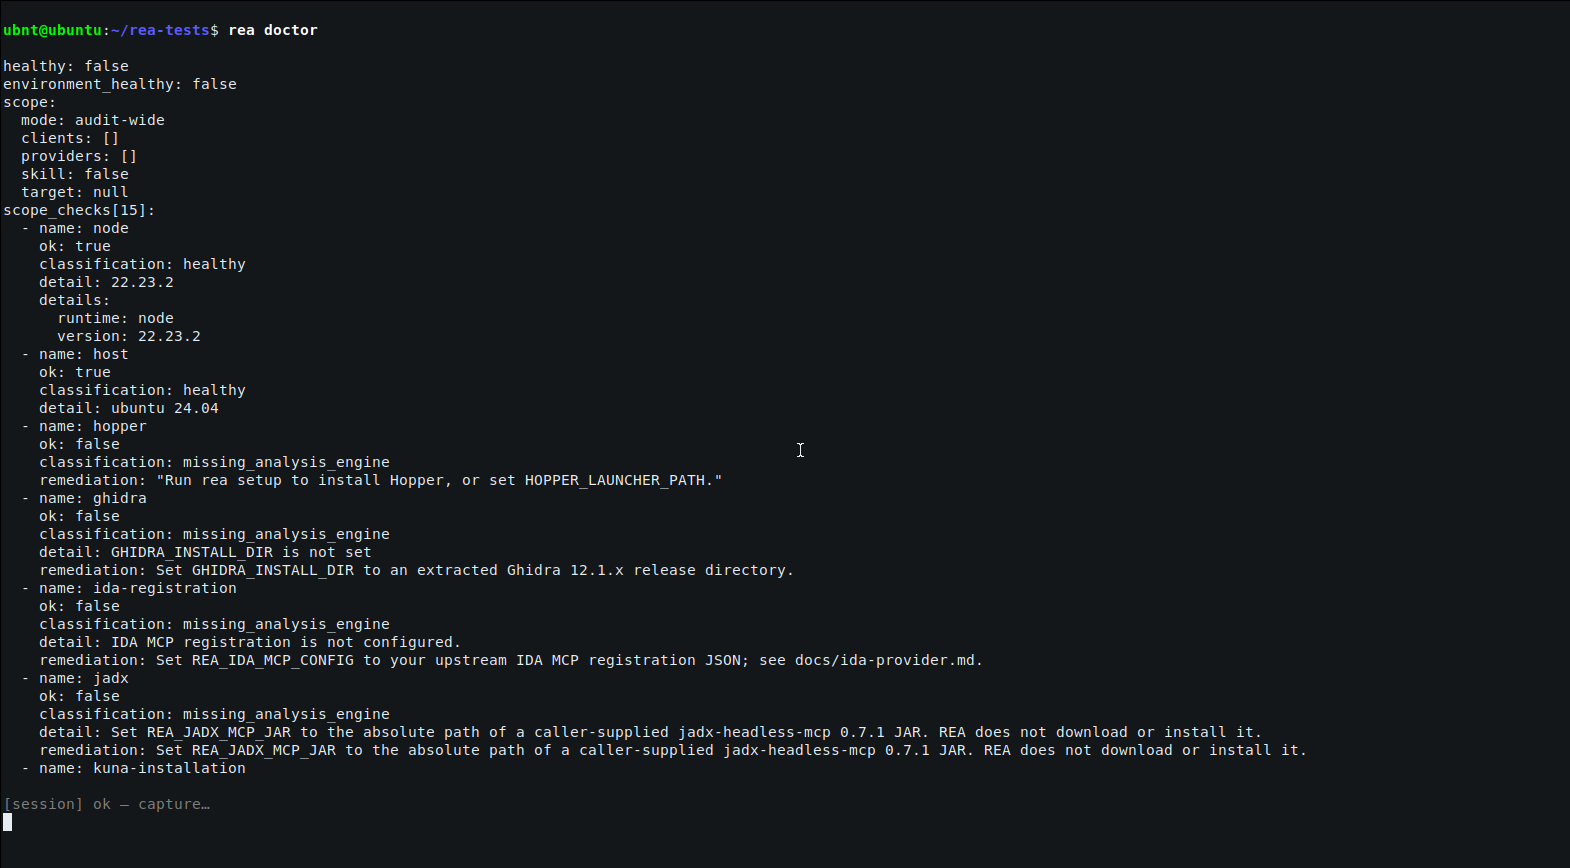
rea doctor : Node 22 et Ubuntu 24.04 sont validés, mais Hopper, Ghidra, IDA, JADX et Kuna sont absents de la machine de test.Voilà exactement ce que nous donne rea doctor sur une machine propre : Node 22.23.2 et Ubuntu 24.04 sont validés, mais les moteurs d’analyse native sont absents, et REA refuse de les installer à votre place — chaque remédiation demande une variable d’environnement que vous configurez vous-même (GHIDRA_INSTALL_DIR, REA_JADX_MCP_JAR, HOPPER_LAUNCHER_PATH…). Cette philosophie « rien ne s’installe sans vous » est une force côté confiance, mais elle impose du travail de premier démarrage.
Nos tests sur le terrain
Toutes les captures de cet article proviennent de sessions réelles, exécutées le 30 octobre 2026 sur notre poste Ubuntu 24.04 avec rea 6.7.0.
1. La santé du serveur MCP : 207 outils exposés
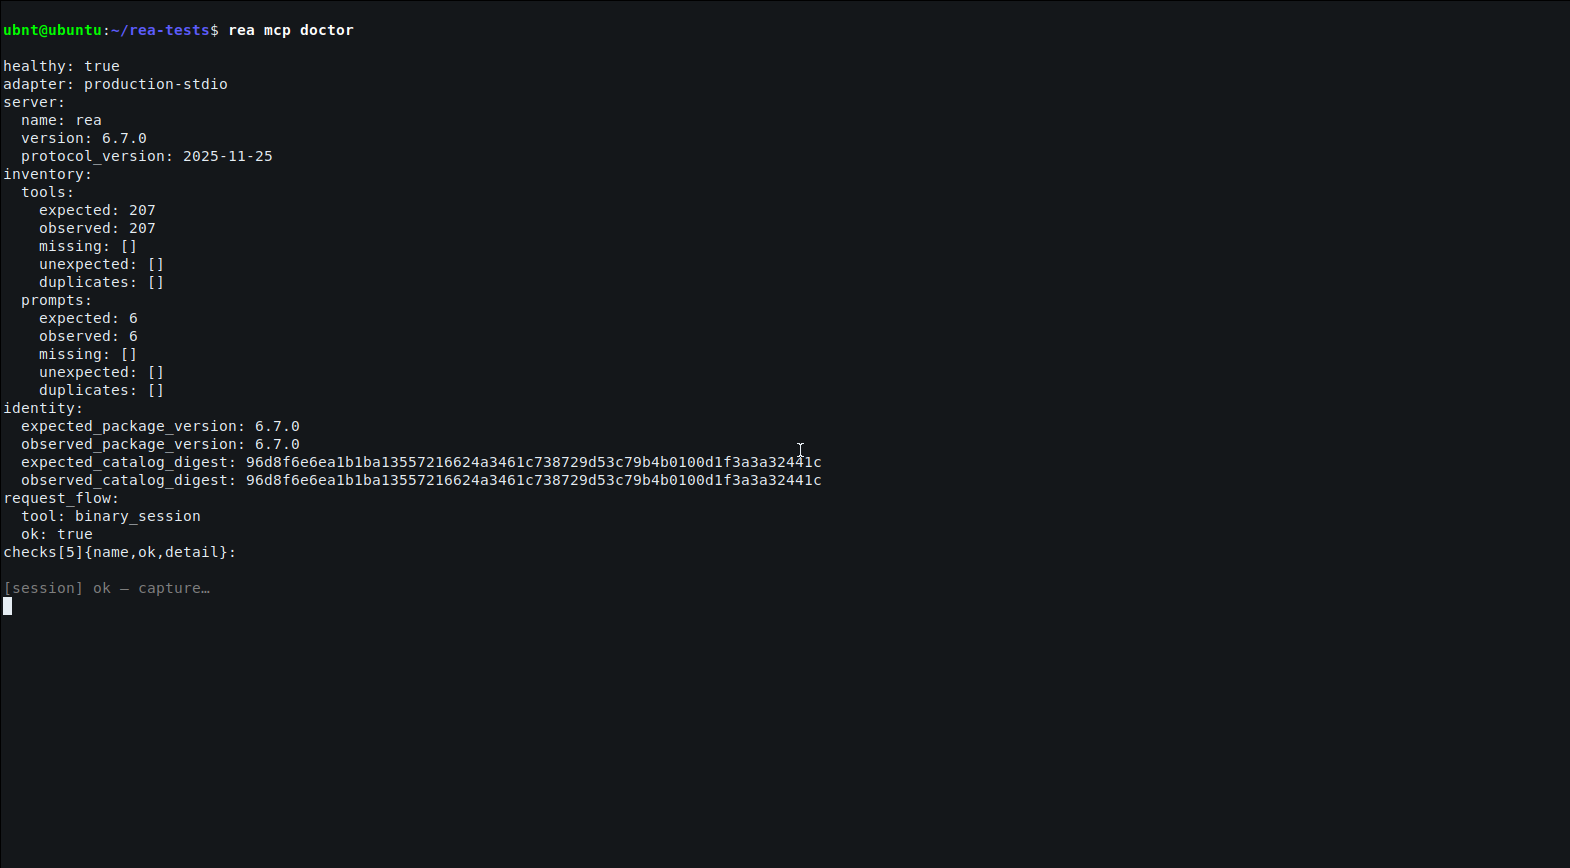
rea mcp doctor : le serveur MCP répond « healthy » avec 207 outils et 6 prompts, inventaire complet et empreinte de catalogue vérifiée.Premier contrôle, le plus important pour brancher REA à un agent : rea mcp doctor renvoie healthy: true, 207 outils attendus et 207 observés, 6 prompts, aucune anomalie d’inventaire, et une empreinte de catalogue identique entre la version installée et celle annoncée. Concrètement, votre agent dispose de 207 actions d’analyse, du désassemblage à l’écoute de trafic réseau, sans qu’une seule ligne de code cible ne soit exécutée.
2. Le JavaScript d’un site web analysé en 4 secondes
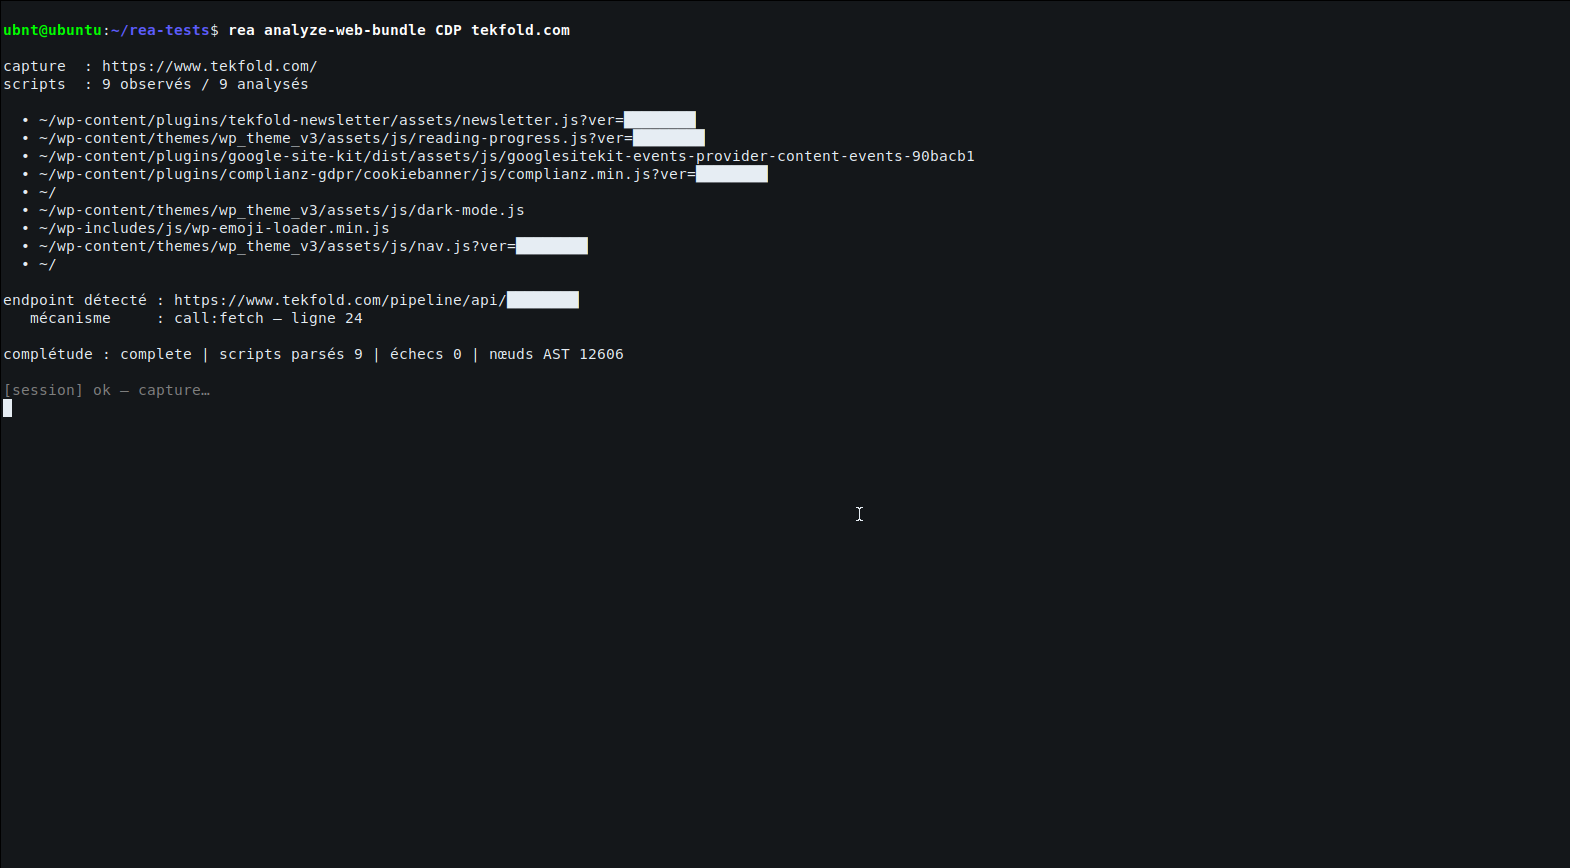
analyze-web-bundle : 9 scripts observés et analysés, 12 606 nœuds AST, et un endpoint API détecté ligne 24 du script principal. (Versions des plugins et chemin de l’endpoint masqués pour des raisons de sécurité.)Pour une cible web, REA se branche au navigateur via le protocole DevTools (CDP) : nous avons lancé Chrome en mode headless sur tekfold.com, puis lancé analyze-web-bundle. Résultat en 4 secondes : 9 scripts observés, 9 analysés, 12 606 nœuds AST parcourus, zéro échec de parsing — et un vrai tuyau remonté : un endpoint API interne (chemin masqué), localisé ligne 24 du script principal, appelé via fetch. Voir d’où vient telle fonctionnalité d’un site concurrent, avec la ligne de code à l’appui, devient un jeu d’enfant.
3. Un APK Android passé au crible
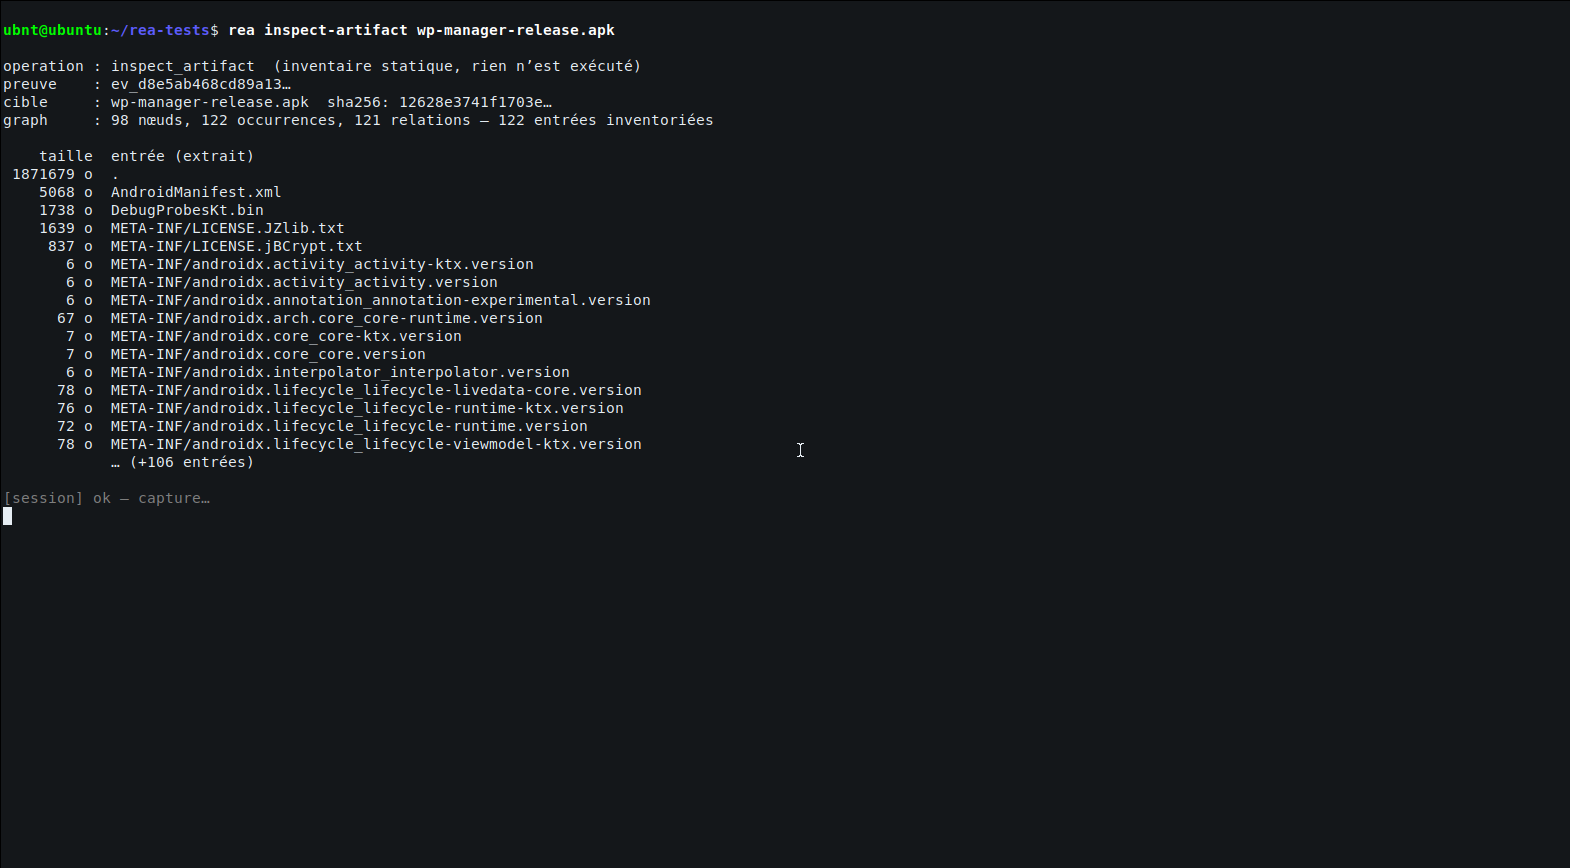
inspect-artifact : inventaire statique de notre APK (98 nœuds, 122 entrées) sans jamais exécuter le fichier.Notre propre paquet wp-manager-release.apk est inventorié en une poignée de secondes : 98 nœuds de graphe, 122 occurrences, 122 entrées listées avec leur taille (manifest, classes.dex de 5 Mo, ressources, métadonnées Kotlin…). Tout est statique : l’APK n’est jamais installé ni lancé sur l’appareil.
4. Le désassemblage natif, avec preuves
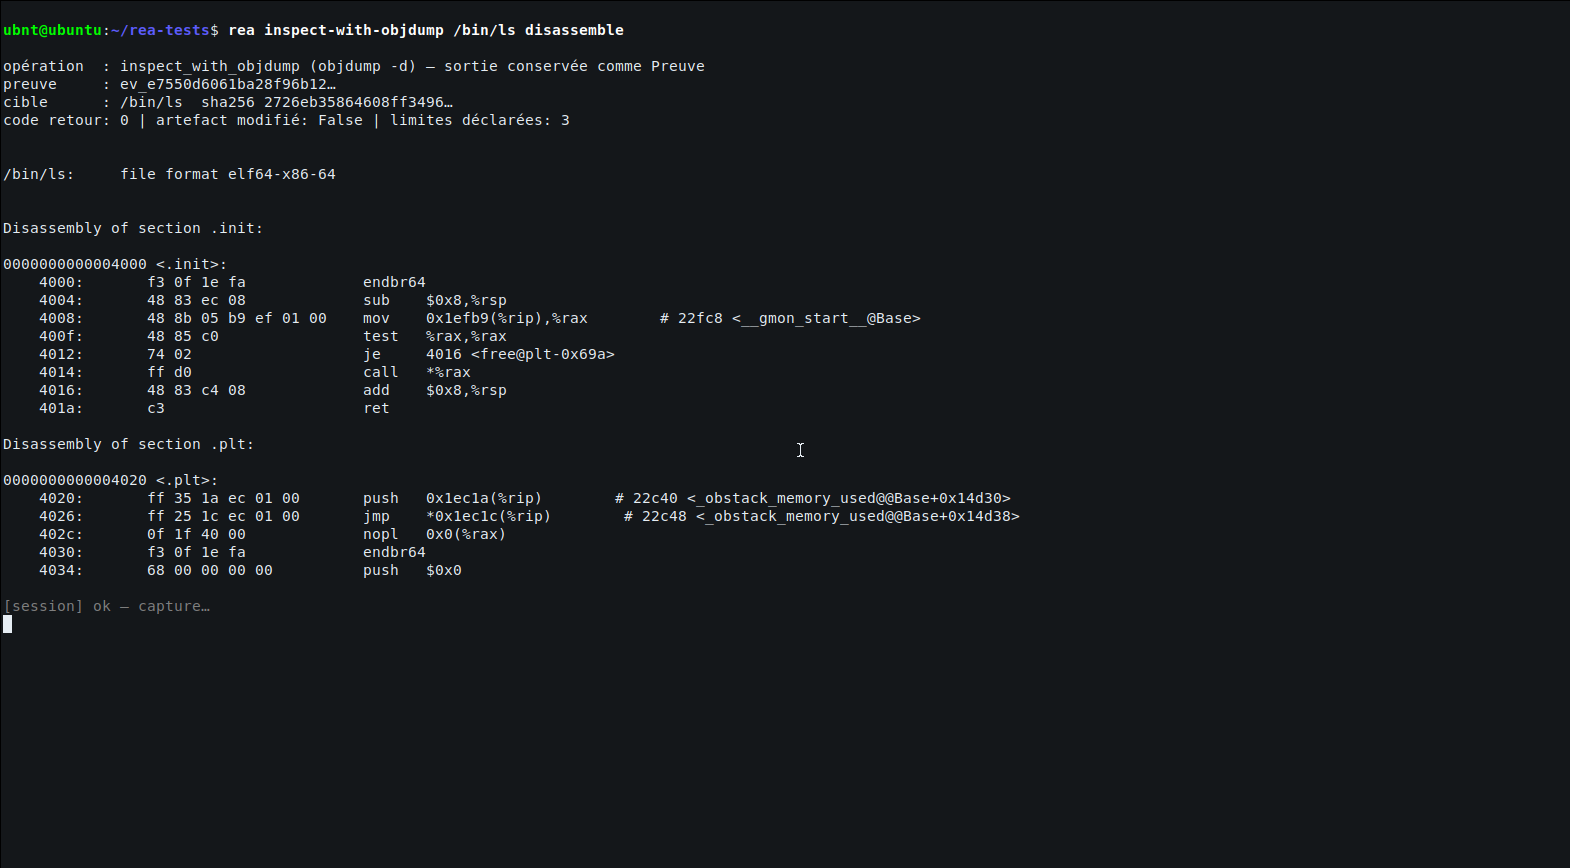
inspect-with-objdump : le désassemblage de /bin/ls est livré avec SHA-256, code retour et limites déclarées.Sur /bin/ls, l’opération inspect-with-objdump produit l’enveloppe de preuve complète : identifiant d’épreuve, SHA-256 du binaire, sortie désassemblée (21 650 lignes), code retour 0, confirmation que l’artefact n’a pas été modifié, et 3 limitations explicitement déclarées. Ce niveau d’honnêteté est rare : l’outil dit toujours ce qu’il ne peut pas prouver.
| Test | Commande | Durée | Résultat |
|---|---|---|---|
| Santé du serveur MCP | rea mcp doctor |
≈ 2 s | 207/207 outils, healthy |
| Bundle web live | analyze-web-bundle |
≈ 4 s | 9 scripts, 1 endpoint découvert |
| Inventaire APK | inspect-artifact |
≈ 4 s | 122 entrées, statique |
| Désassemblage ELF | inspect-with-objdump |
≈ 1 s | 21 650 lignes, preuve complète |
| Bundle VS Code (41 fichiers) | analyze-javascript-application |
7 min 45 s | Succès avec limites de budget |
Test charge : 7 minutes 45 sur le bundle de VS Code
Pour vérifier les limites, nous avons passé à REA le dossier out de VS Code (41 fichiers JavaScript, dont des bundles de plusieurs mégaoctets). L’analyse a abouti (DONE_EXIT=0) en 7 min 45 s, mais l’enveloppe de résultat comporte 47 limitations : plusieurs graphes sémantiques ont dépassé le budget alloué au résultat, et deux fichiers géants (workbench.desktop.main.js et sessions.desktop.main.js) ont épuisé la mémoire de leur worker. REA conserve alors les faits statiques et signale honnêtement que la couverture du graphe est incomplète. Autrement dit : sur des cibles de cette taille, l’outil reste utile, mais il ne remplace pas encore une analyse guidée, fichier par fichier.
Les avantages et les inconvénients
| Avantages | Inconvénients |
|---|---|
| Une seule couverture MCP/CLI pour le binaire, le JS/Electron, le web, .NET, l’Android, le WASM et le réseau. | Moteurs natifs (Ghidra, Hopper, IDA, JADX, Kuna) à fournir soi-même : rea doctor reste en healthy: false sur une machine vierge. |
| Chaque conclusion est livrée avec preuve, empreinte SHA-256, code retour et limitations : idéal pour un usage agentic auditable. | Sorties très verbeuses (plusieurs millions de lignes sur un gros test) : il faut --filter-output, --token-limit pour ne pas saturer le contexte d’un agent. |
| Analyse strictement locale et statique : la cible n’est jamais exécutée, ce qui réduit le risque sécuritaire. | Performance dégradée sur les très gros bundles (7 min 45 s et graphes tronqués par budget de résultat). |
| Intégration native à Claude Code, Codex, Cursor, Gemini CLI, OpenCode, VS Code, Copilot CLI + 155 commandes CLI. | Courbe d’apprentissage forte : vocabulaire maison (Evidence, substep, catalogue MCP) et API qui évolue vite (642 pull requests ouvertes). |
| Licence MIT, projet très actif (release toutes les une à deux semaines), documentation abondante. | Dépendances à installer manuellement (paquet frida bloqué par npm, REA_PWNTOOLS_PYTHON à configurer pour l’ELF avancé). |
Questions fréquentes
REA est-il gratuit ? Oui : le projet est sous licence MIT, publié sur npm (rea-agents) et sur GitHub. Seuls certains moteurs d’analyse tiers (notamment Hopper et IDA) sont commerciaux — Ghidra, lui, est gratuit mais doit être téléchargé et configuré séparément.
Faut-il être expert en reverse engineering pour l’utiliser ? Non, et c’est tout l’intérêt du format MCP : on pose une question en langage naturel (« comment ce site gère-t-il son mode sombre ? ») et l’agent choisit les opérations adaptées. En revanche, savoir lire une sortie d’analyse (sections ELF, graphe d’appels, endpoints) reste un plus décisif pour ne pas avaler une conclusion à l’aveugle.
REA exécute-t-il les fichiers que j’analyse ? Non pour les opérations statiques testées ici (JS, APK, ELF via objdump) : elles lisent et projettent les octets sans lancer le programme. Les opérations dynamiques (instrumentation Frida, scénarios navigateur) sont signalées comme telles dans les capacités de l’outil et demandent votre accord explicite.
Que faire si rea doctor affiche « healthy: false » ? C’est le comportement attendu sur une machine neuve : les moteurs d’analyse native sont listés avec leur remédiation. Pour démarrer sur le web ou le JavaScript, aucun moteur n’est nécessaire ; pour le binaire natif, installez Ghidra puis renseignez GHIDRA_INSTALL_DIR.
Notre avis : un outil de référence, encore austère
REA n’est pas un jouet : c’est une infrastructure sérieuse, pensée pour être consommée par des agents, qui traite l’honnêteté des résultats comme un first citizen. Les tests réalisés ici — 207 outils MCP vérifiés, analyse web en 4 secondes avec endpoint interne découvert, inventaire d’APK, désassemblage preuve à l’appui — sont tous concluants. Les défauts sont ceux d’un projet qui va très vite : première installation fastidieuse, sorties massives à domestiquer, et un comportement dégradé sur les bundles géants.
Recommandation : à adopter dès maintenant pour les équipes produit et sécurité qui veulent « comprendre la concurrence » (analyse de sites, d’APK, de protocoles) et pour tout développeur qui utilise déjà un agent compatible MCP. Prévoyez une heure de configuration initiale et gardez à l’esprit que REA fournit des preuves, pas des certitudes : relisez les limitations qu’il affiche. Note de la rédaction : 8,5/10.